会干活的 AI 员工留不下经验,才是最大的浪费
数字员工成长 · C1 | 作者视角:解决方案架构师
我给自己的主力数字员工派过一个活:把一段带外部观点的文案转成短视频——逐句配音、图文卡片随内容切换、混音、渲染、自检。第一版出来就翻车了:段落停顿处露出纯字幕空白页,有两帧画面完全是黑的;换一份文案再跑,覆盖率又被打穿到 4%。
放到传统团队,这叫”新人上手成本”。放到数字员工身上,问题更尖锐:**它的”记忆”是会话级的,对话关掉就没了。**如果踩坑的教训只存在于那一次对话里,下一个文案、下一周、另一个会话,它会在同一个坑上原样摔第二跤。
那天晚上修完问题,我做了一个后来被证明最值钱的动作:把修复结论写成铁律,存进一个叫 short-video-synthesis 的技能目录。从那以后,这类坑它再没踩过,第二次执行直接出成品。
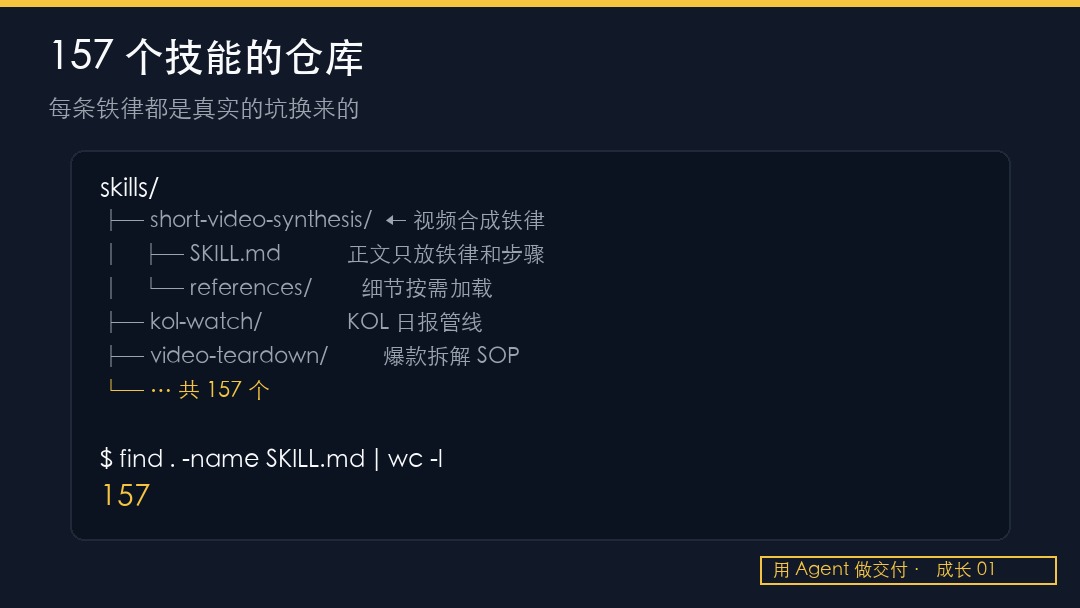
Skill 是什么,为什么不是又一个提示词库
很多人第一反应:这不就是 prompt 库吗?不是。区别在三点,都是实测出来的。
**第一,它是带元数据的规程,不是散装提示词。**Agent Skills 是一个开放格式标准(agentskills.io,仅供参考不代表认可其生态主张):一个目录加一个 SKILL.md 文件,头部用 YAML 写名称和触发描述——描述里要写清”做什么”和”什么时候用”,agent 靠这两个字段决定要不要加载它。正文没有格式限制,怎么帮 agent 干好活怎么写。
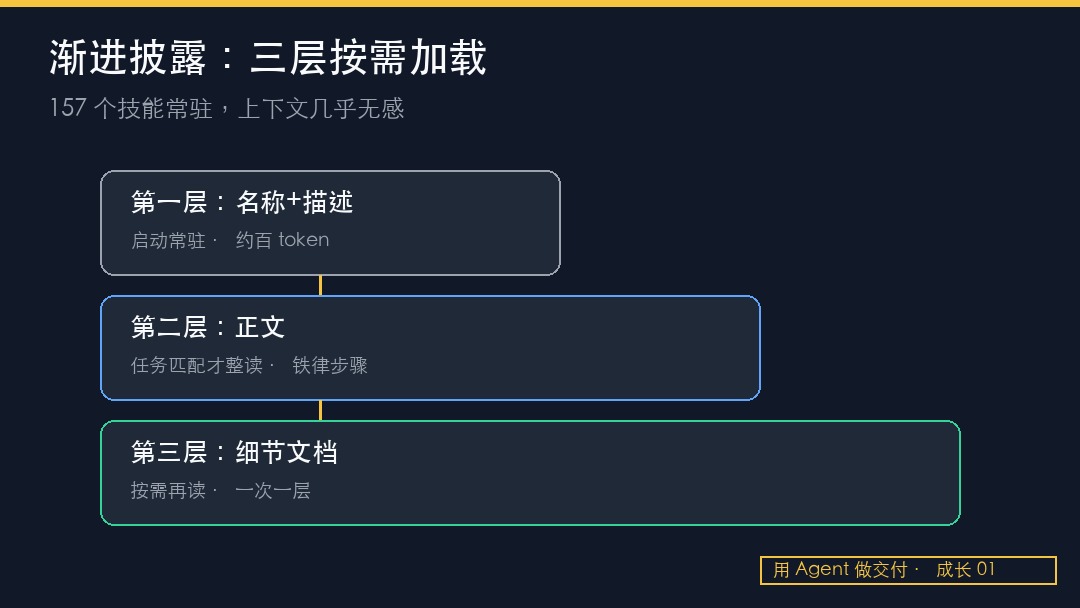
**第二,按需加载,不占常驻上下文。**规范里叫渐进披露(progressive disclosure),分三层:启动时全量加载的只有名称和描述(约百 token 级);任务匹配上了才整读正文;细节文档和脚本按需再读。我测过的体感是:157 个技能常驻,上下文几乎无感;不用 Skill 的做法,塞 157 段提示词早就把窗口挤爆了。
**第三,可迭代、可迁移。**技能目录整个进 git,每次翻车修复都有 commit、有 diff、可回滚;整个目录拷给另一台机器上的另一个 agent,就能用。这两条是提示词库做不到的——提示词库改坏了没人知道,搬家要靠人肉复制粘贴。
一个 Skill 的 110 分钟进化史
讲机制不如看实物。下面这个技能的演化时间轴,每个时间戳都来自真实的 git 记录,可查证。
**20:34,出生。**从平台发布技能里拆出来的,因为”视频合成”和”发到哪个平台”是两件事,混在一起改哪个都牵动另一个。拆出来时正文只有 38 行:分句配音同步规则、卡片覆盖兜底、渲染自检。(commit 22e1534)
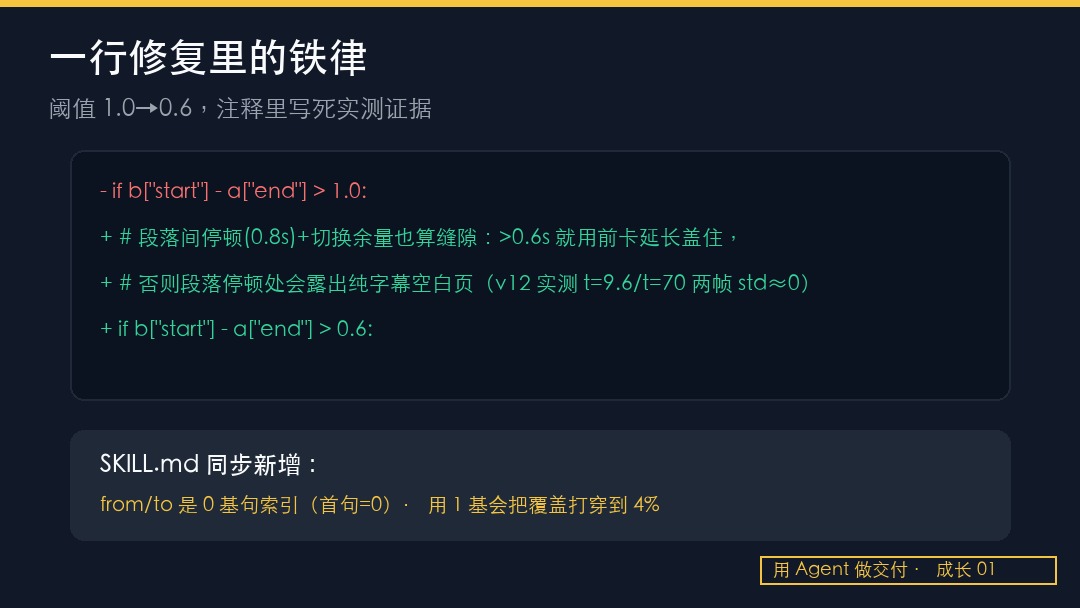
**21:47,第一次翻车修复。**就是开头说的空白页。定位是卡片缝隙判定阈值太宽:段落间正常有 0.8 秒停顿,脚本只在缝隙大于 1.0 秒时才用上一张卡延长盖住,0.8 秒的停顿刚好漏过去,露出两帧空白(实测 t=9.6 和 t=70 两处,帧间标准差≈0)。修复 diff 就一行——阈值 1.0 改 0.6,但注释里写死了实测证据:
- if b["start"] - a["end"] > 1.0:
+ # 段落间停顿(0.8s)+切换余量也算缝隙:>0.6s 就用前卡延长盖住,
+ # 否则段落停顿处会露出纯字幕空白页(v12 实测 t=9.6/t=70 两帧 std≈0)
+ if b["start"] - a["end"] > 0.6:
(commit a654c40)
**22:24,第二次翻车变铁律。**换文案重跑,覆盖率掉到 4%。原因:配置里卡片索引写成了 1 基(首句当 1),实现是 0 基(首句当 0),整个覆盖区间错位打穿。这次修复除了改配置,还在 SKILL.md 里加了一条铁律:“from/to 是 0 基句索引(首句=0)。用 1 基会把覆盖打穿到 4%——覆盖率 fail-fast 会拦,但别依赖它兜底。“顺手立了另外两条:长段落必须按子主题拆卡随句切换(一张静态卡挂 40 秒会出现”语音讲新内容、画面停旧内容”的伪不同步);末尾声明句单独一张卡。(commit b030df6)
**两天后清晨,规模化验证。**又一批实测反馈进来:五个 P0 问题加三风格音画同步,一次修完入库。(commit dbbe257,9 月 18 日 06:17)至此这个技能经过了三轮真实交付的打磨,后面每次执行都是稳定复用。
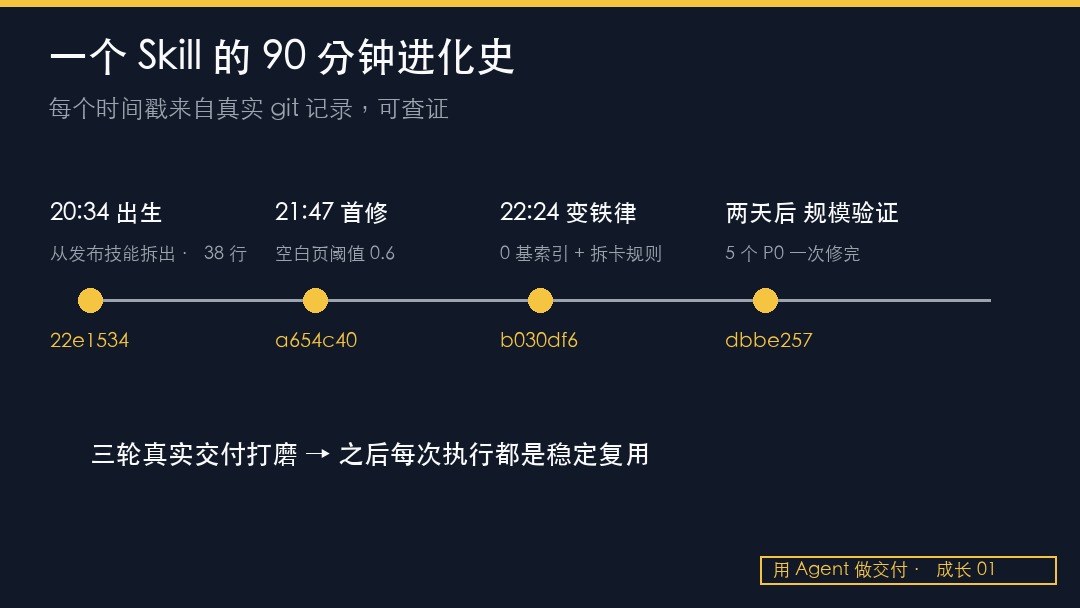
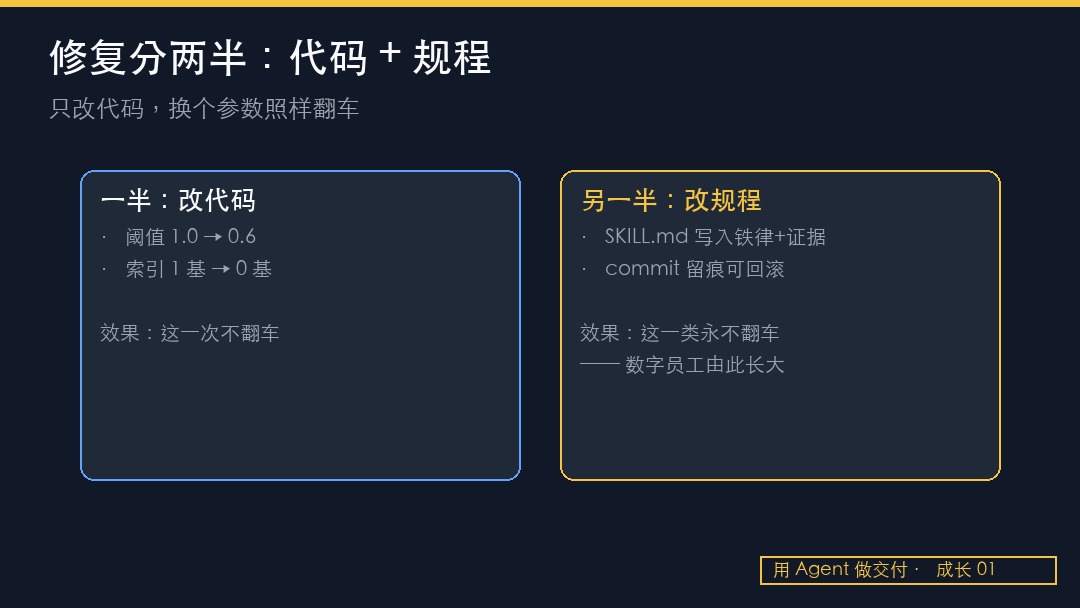
这 110 分钟里最关键的动作,是把修复分成了两半:**一半改代码,一半改规程。**只改代码,下一个文案换个参数照样翻车;只有写进 SKILL.md 的那一半,才算这个数字员工真的”长大了”。
什么能力该 Skill 化,什么不该
跑了大半年,我的判断标准收敛成四条:
- **踩过坑的流程,必须化。**坑是真金白银的渲染时长换来的,一条铁律的成本是五行字,收益是永久免疫。反过来说,没踩过坑的领域别急着写——凭想象立的规矩往往是错的,第一次真实执行再回来改。
- **有确定输入输出的规程,适合。**渲染管线、发布流程、验收清单,步骤明确、结果可检,agent 照着执行就能复现质量。
- **一次性探索和纯判断,不适合。**为探索过程写规程,写下来全是”看情况”;判断型能力(比如审美)写成文字就变废话。这类留给人或留给强模型现场发挥。
- **需要实时数据的,规程只写”怎么取数”,别把数写死。**写死的数字会过期,取数方法不会。
最后一个工程细节:规范建议正文不超过 500 行。这不是文档洁癖——agent 每次激活技能都要把正文整读进上下文,正文越长,每次的执行成本越高。我的实践是正文只放铁律和步骤,细节拆到 references/ 目录按需读,规范自己也这么建议(分层引用,一次一层)。
收个尾。员工会离职,会话记忆会过期,只有沉淀成标准格式的经验可以跨会话、跨机器、跨 agent 迁移。数字员工的成长,不体现在它今天有多聪明,体现在它的技能目录又厚了几行——而每一行,都是真实的坑换来的。
(本文技能演化史来自本人技能仓库的真实 git 记录,commit 编号文中已列,可复查。观点仅供参考。)